Введение
Perplexity AI — это AI-поисковик, который сочетает возможности языковых моделей и поиска в интернете.
Он:
• находит актуальную информацию в сети
• анализирует её с помощью AI
• формирует структурированный ответ с ссылками на источники
В отличие от классических чат-ботов, Perplexity опирается на реальные источники, а не только на обученные данные, позволяет проверять ответы через цитаты и ссылки, поддерживает уточняющие вопросы и диалоговый поиск.
В 2026 году Perplexity вырос из поисковика в рабочую среду: появились Проекты (Projects) для долгой работы над темой, создание файлов и приложений, ИИ-агент Computer и браузер Comet.
Ключевые возможности
Рассмотрим основные инструменты, которые превращают Perplexity в полноценную рабочую станцию для исследователей и аналитиков.
Глубокое исследование и умный поиск
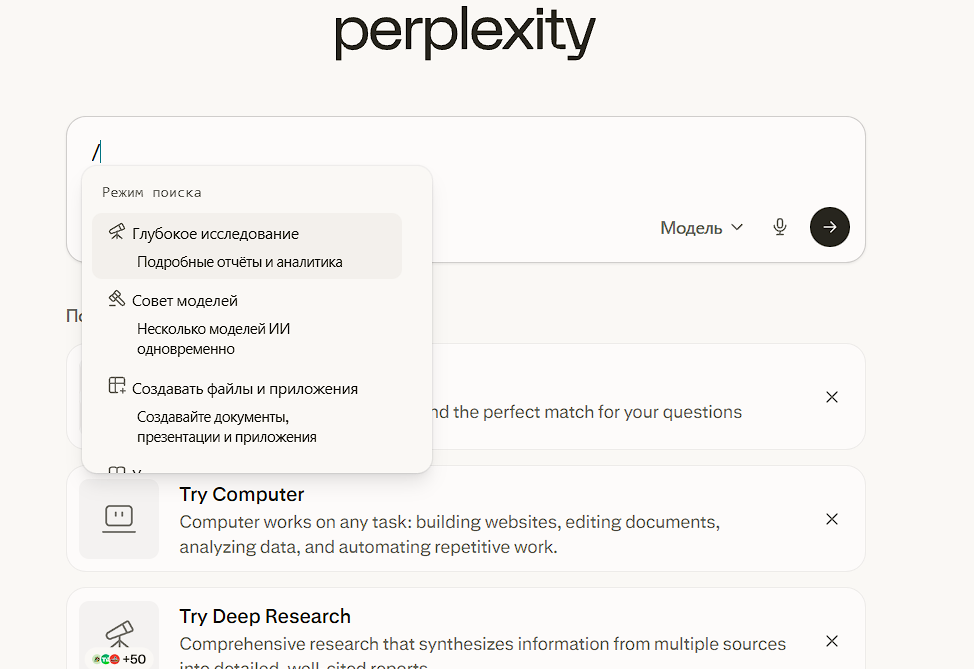
В строке поиска есть обычный поиск (Search) для быстрых ответов и режим «Исследование» (Research, он же Deep Research) для сложных тем. В режиме Research Perplexity выполняет десятки поисковых запросов, читает сотни источников и собирает подробный отчёт — обычно до 3 минут, иногда 4–5. Отчёт можно экспортировать в PDF или документ либо превратить в страницу Perplexity Page. Как работает Perplexity сейчас:
Запрос
Вы задаёте вопрос (можно сложный или исследовательский).
Поиск и анализ
Perplexity ищет информацию в интернете, отбирает релевантные источники и анализирует их с помощью AI. В режиме Research он по ходу работы уточняет план поиска и рассуждает над найденным.
Ответ с источниками
Вы получаете структурированный ответ, ссылки на источники и возможность углубиться в тему.
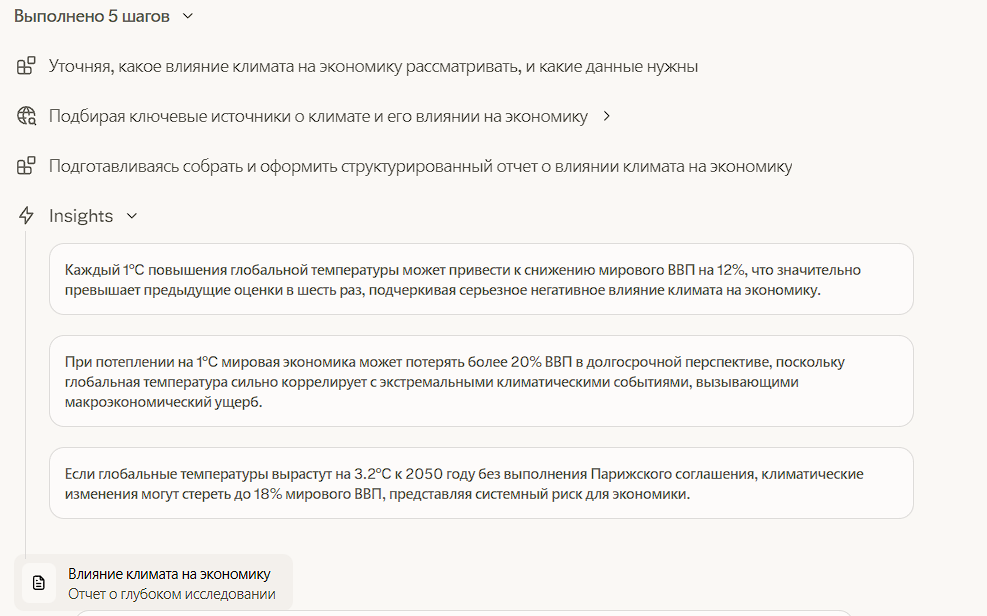
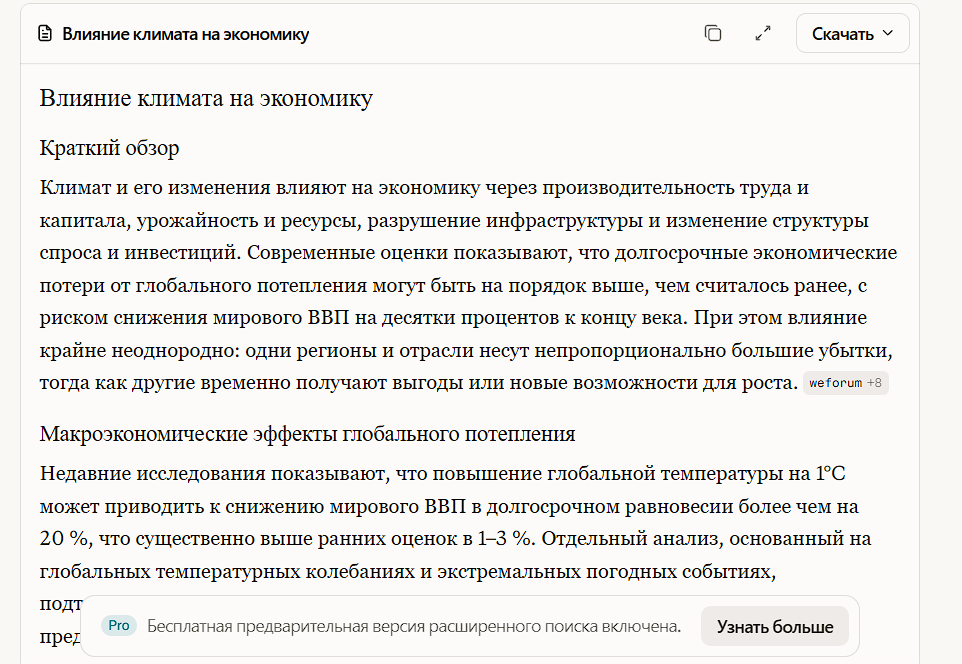
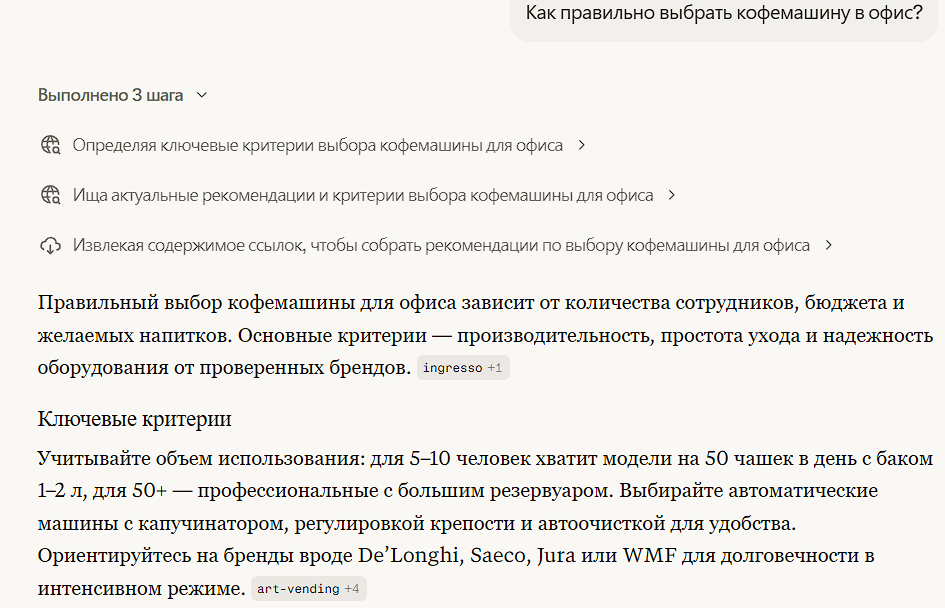
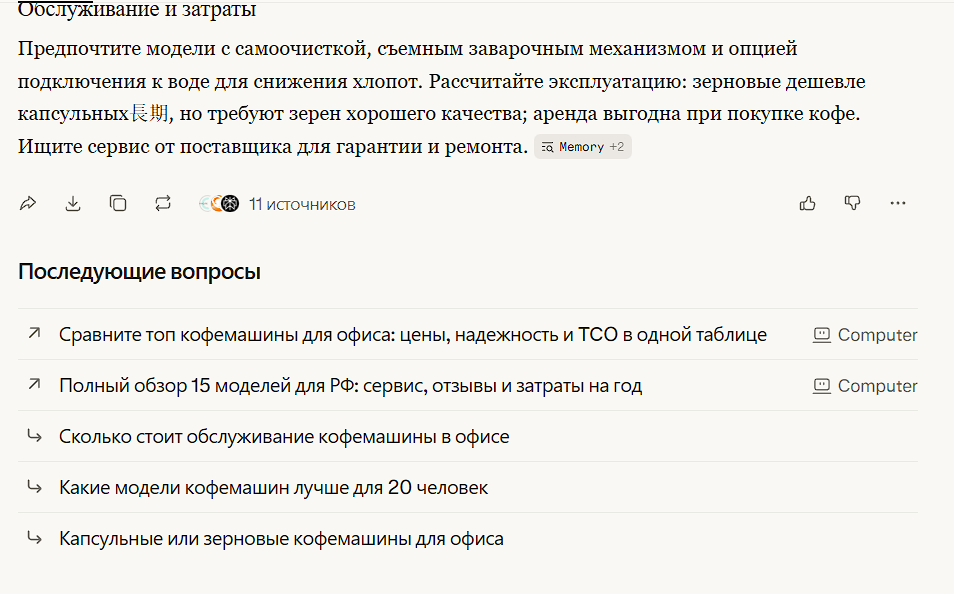
Важное уточнение: в бесплатной версии доступны практически безлимитный базовый поиск, 3 Pro-поиска в день и 1 запрос в режиме Research в месяц. Лимиты восстанавливаются постепенно (скользящее окно), а не в фиксированную дату. В обычном поиске после каждого ответа ИИ сам предлагает связанные вопросы, либо вы можете набрать своё уточнение, как в обычных чатах. На платных тарифах Deep Research становится встроенным навыком агента Computer: его можно запустить через меню + или символ / в строке поиска.
1. Организация знаний с помощью Проектов (Projects)
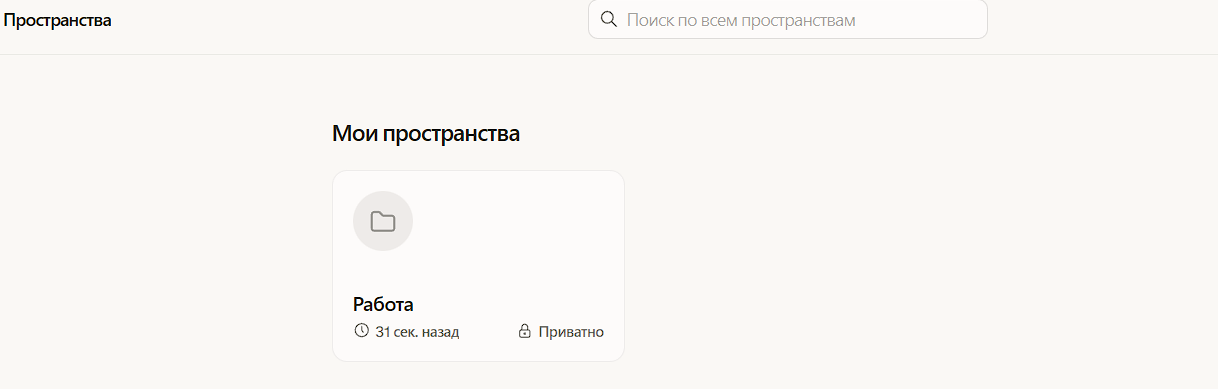
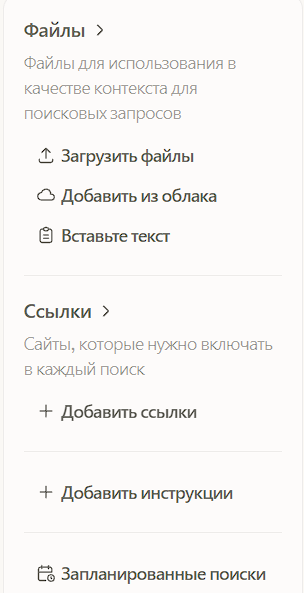
Projects — это рабочие пространства Perplexity для долгой работы над темой, проектом или задачей. 30 июля 2026 года они пришли на смену «Пространствам» (Spaces), которые в свою очередь заменили «Коллекции»; старые Spaces перенеслись автоматически. В проекте хранятся поисковые треды и задачи агента Computer, файлы, инструкции для ИИ (до 8 000 символов) и подключённые приложения. Проектом можно поделиться: до 5 участников, а для подтверждённых студентов, преподавателей и организаций — до 9 999.
Фишка: файлы, загруженные в проект, используются в любом чате внутри него (до 10 000 файлов и 5 ГБ на проект, до 100 МБ на файл), а память Brain постепенно накапливает контекст вашей работы. Файлы из подключённых приложений (например, Google Drive) копируются один раз и сами не обновляются. Проекты встроены в агента Computer, поэтому полноценно работают на платных тарифах.
2. Анализ собственных документов (Загрузка файлов)
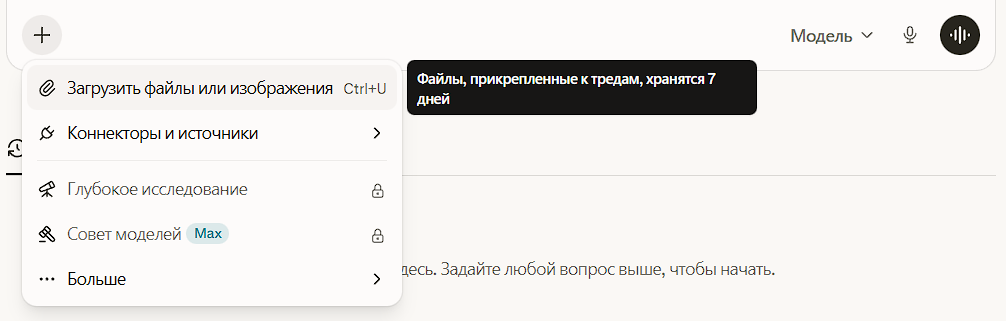
В Perplexity можно прикреплять файлы прямо к запросу через кнопку + Attach в строке поиска или простым перетаскиванием файлов и даже целых папок в окно чата. Сервис работает с текстом, кодом, PDF, таблицами, изображениями, аудио (MP3, WAV, OGG, FLAC и др.) и видео (MP4, MOV, AVI, WebM и др.).
Речь в аудио- и видеофайлах автоматически переводится в текст (транскрибируется), спикеры распознаются и подписываются, поэтому по записи можно задавать вопросы и искать нужные фрагменты. Картинка в видео при этом не анализируется. Размер одного файла — до 40 МБ: короткие файлы читаются целиком, из длинных Perplexity извлекает самые важные части.
Ограничения: на всех тарифах действует недельный лимит загрузок со скользящим окном — каждый файл перестаёт учитываться примерно через неделю. В бесплатной версии лимит небольшой, в Pro больше, в Max ещё выше. Файлы из Google Drive и других подключённых приложений тоже входят в лимит.
3. Персонализация и открытие нового
Настройки профиля
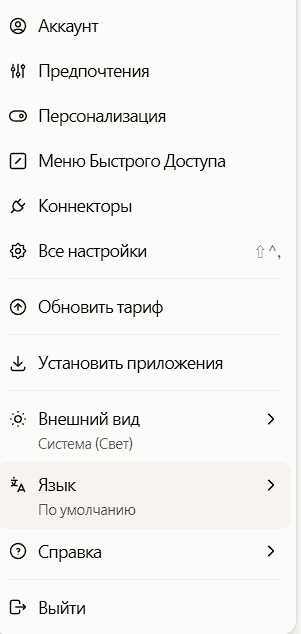
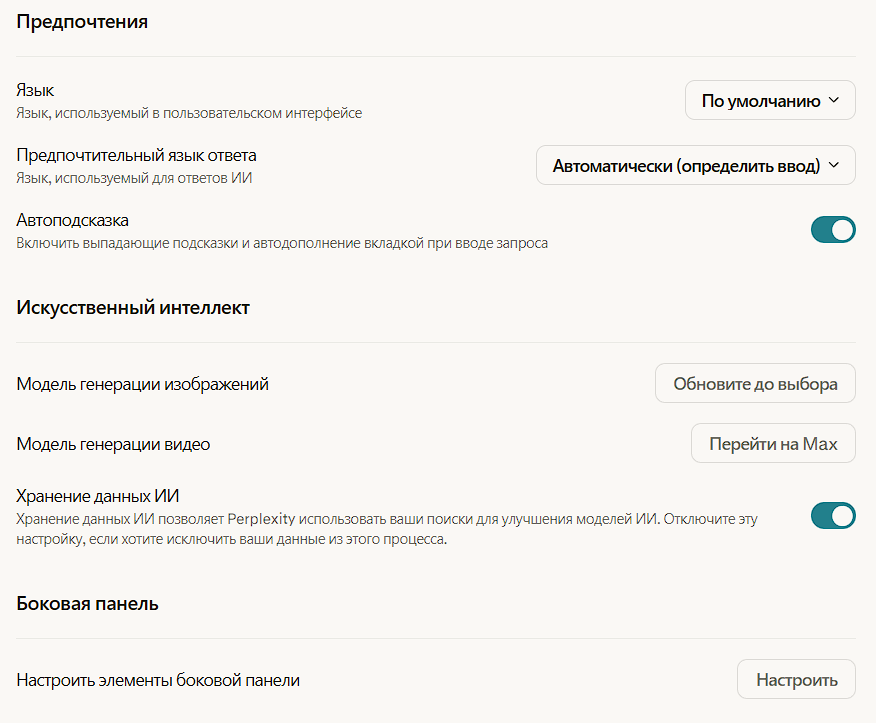
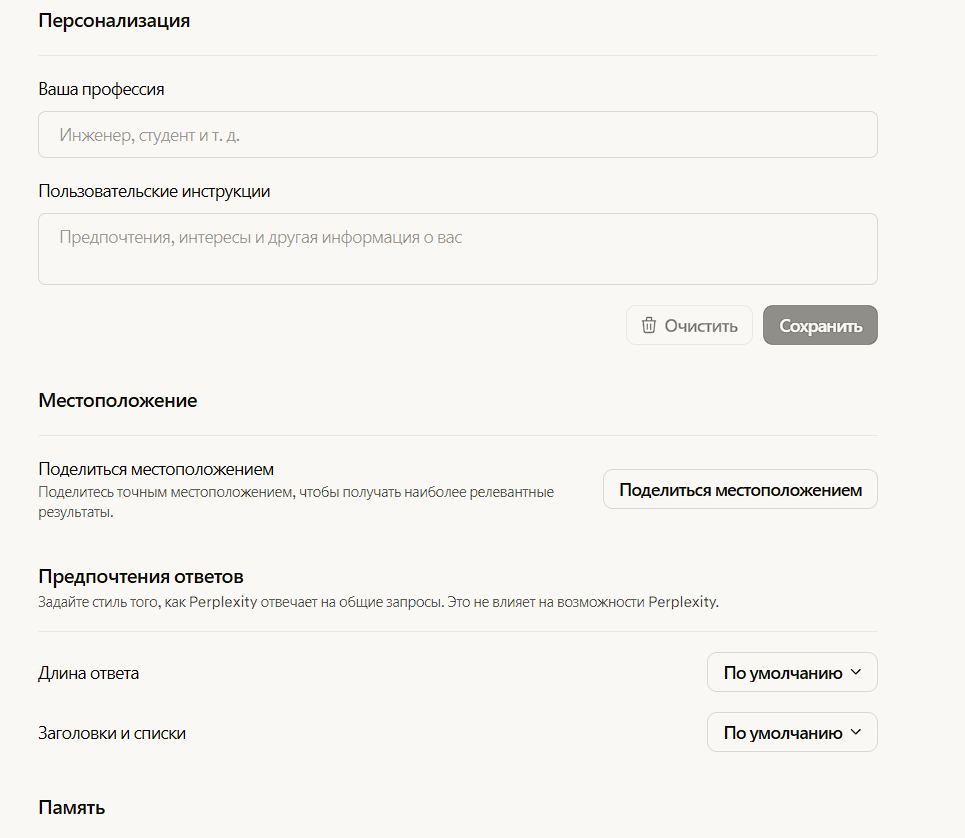
В разделе Profile настроек можно указать предпочтительный формат ответов, интересы, стиль общения (формальный или неформальный), цели, язык ответа, местоположение и «особые условия» — знания или правила, которые будут учитываться в каждом запросе.
Дополнительно работает Память (Memory): Perplexity запоминает ваши предпочтения и учитывает историю поиска, а в ответе показывает, какие воспоминания использовал. Настраивается в Settings → Memory; в режиме инкогнито память всегда выключена.
Примечание: В бесплатной версии модель выбирается автоматически (режим Best), вручную выбрать продвинутую модель нельзя. В Pro доступны, например, GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash, Kimi K3 и Grok 4.7; в Max дополнительно GPT-6 Astra, Claude Opus 5.5 и Gemini 4 Argon (список на октябрь 2026 года, он регулярно меняется).
Обзор (Discover)
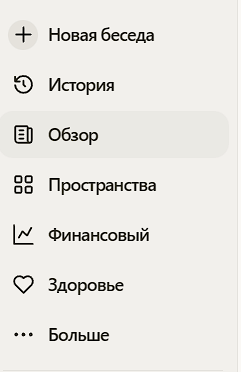
Отдельно работает Обзор (Discover) — лента актуальных новостей и тем, которые собирает и кратко пересказывает ИИ, со ссылками на первоисточники. Ленту можно настроить под свои интересы и язык, а темы разбиты по разделам (технологии и наука, финансы, культура, спорт и др.). Через неё удобно находить новые идеи и направления для исследования. Эти возможности доступны и в бесплатной версии.
4. Новое в 2026 году: файлы, агент Computer и браузер Comet
Создание файлов и приложений (Create files and apps)
Режим, который пришёл на смену Perplexity Labs. Он собирает по вашему запросу документы (DOCX, PDF), таблицы (XLSX), презентации (PPTX) и простые веб-приложения (HTML), добавляя в них результаты поиска и изображения. Готовый файл можно доработать уточняющими сообщениями или сконвертировать в другой формат. Режим находится рядом с Search и Research и доступен на платных тарифах.
Агент Computer
Computer — автономный ИИ-агент, «цифровой сотрудник», который не просто отвечает, а выполняет задачи: проводит исследование сразу по многим направлениям с помощью субагентов, подключается к Gmail, Outlook, GitHub, Slack, Notion и другим сервисам, работает в фоне и по расписанию, выстраивает цепочки «исследование → документ → письмо» и помнит контекст между сессиями. Доступен только по подписке; задачи агента расходуют кредиты, а обычные поисковые запросы — нет.
Браузер Comet
Comet — браузер Perplexity со встроенным ИИ-ассистентом, который может пересказать страницу, сравнить вкладки или выполнить действие на сайте. Сам браузер бесплатен для всех и работает на Windows, Mac, iOS и Android, а запросы к агенту-ассистенту Comet входят в платные тарифы с месячными лимитами.
Продвинутые техники промптинга
Чтобы раскрыть весь потенциал Perplexity, используйте техники, ориентированные на поиск и анализ информации.
1. Источники и коннекторы (Sources)
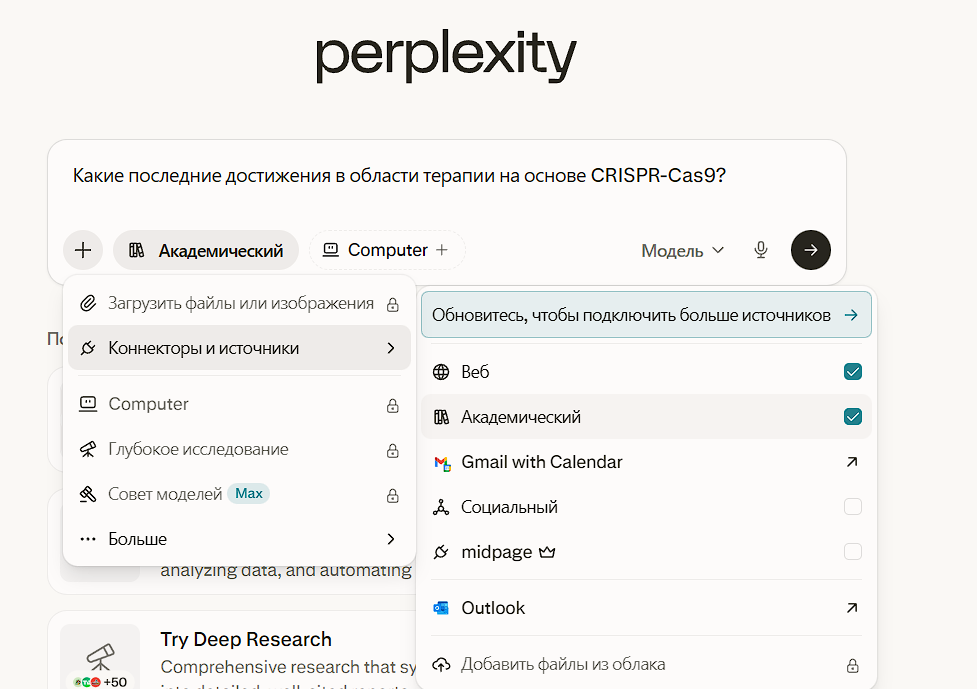
Чтобы получить более точный ответ, сразу указывайте, где искать информацию. В меню источников у строки поиска можно выбрать Web (интернет), Academic (научные публикации), Social (обсуждения, например Reddit) и Finance (финансовые данные и отчёты компаний), а на платных тарифах — ещё и подключённые приложения: Google Drive, Gmail, Notion и другие. Такой подход сужает поиск и повышает качество ответа, а контекст внутри треда сохраняется для последующих уточнений.
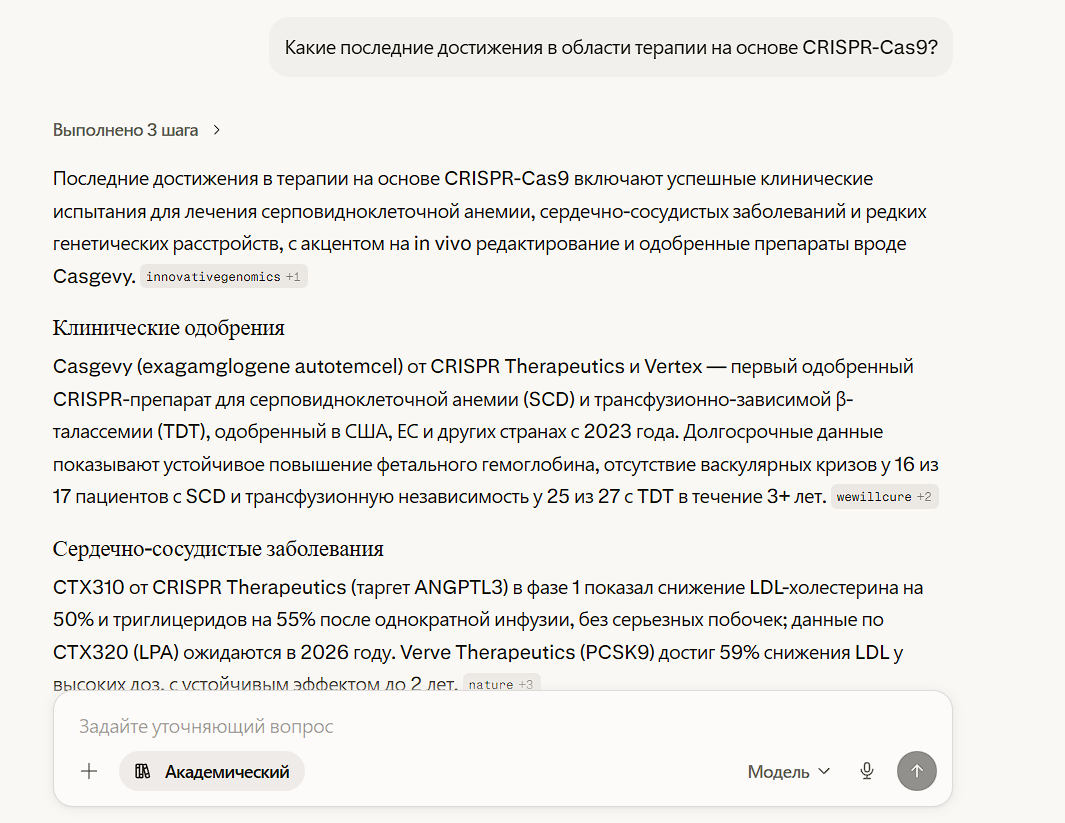
Рядом с некоторыми ссылками в ответе стоят метки источников: Government (официальные госсайты), Academic (научные ресурсы) и Trusted (сайты, которые публикуют материалы в своей области экспертизы). Наведите курсор на источник, чтобы увидеть метку и краткое описание.
Промпт: "Найди последние клинические результаты по CRISPR-Cas9, опираясь на научные публикации и обзоры."
Обратите внимание: выбор источника — это пожелание, а не жёсткий фильтр. Даже в режиме Academic в ответ могут попасть обычные веб-страницы, поэтому проверяйте ссылки. Если сайт без метки — значит, его ещё не оценили, а не что он плохой.
2. Запрос на сравнение и анализ
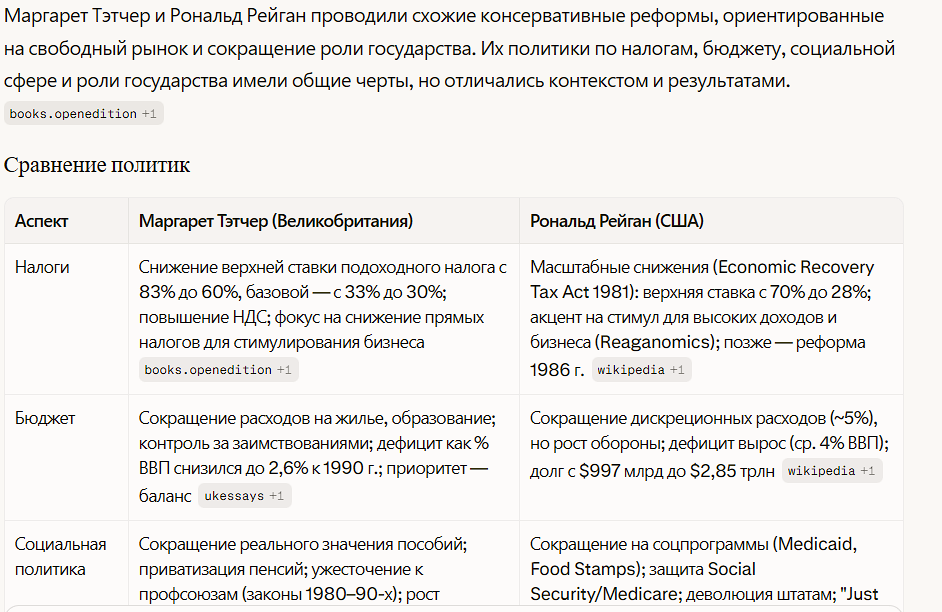
Perplexity особенно полезен, когда нужно сравнить несколько вариантов по понятным критериям. Чтобы ответ был действительно полезным, лучше сразу задать структуру: критерии сравнения, формат ответа и требование привести источники.
Промпт: "Сравни экономические политики Маргарет Тэтчер и Рональда Рейгана по налогам, бюджету, социальной политике и роли государства. Ответ дай в таблице, а после таблицы кратко выдели ключевые сходства и различия со ссылками на источники."
3. Итеративное исследование в одном треде
Используйте Perplexity как цепочку связанных уточнений. Начните с общего вопроса, а затем задавайте дополняющие вопросы в том же треде, чтобы сохранялся контекст.
Шаг 1: "Что такое квантовая запутанность?"
Шаг 2 (клик по "связанному вопросу"): "Теперь объясни, как она используется в квантовых вычислениях."
Шаг 3 (свой вопрос): "Приведи примеры физических реализаций кубитов, где важна запутанность, и укажи недавние эксперименты."
ИИ автоматически предлагает логичные уточняющие вопросы после каждого ответа, либо вы можете напечатать свои собственные.
Сравнение и анализ
Сильные и слабые стороны Perplexity в сравнении с другими популярными моделями и поисковыми системами.
Сравнение функций
| Характеристика | Perplexity | ChatGPT | Gemini |
|---|---|---|---|
| Поиск и синтез из веба | Поиск в интернете — основа каждого ответа; синтез из множества источников, режим Research для глубоких отчётов | Есть встроенный веб-поиск и Deep Research, но многие ответы модель даёт из собственных знаний, не обращаясь к поиску | Опирается на поисковый индекс Google и умеет Deep Research; к поиску обращается, когда модель сочтёт нужным |
| Прозрачность источников | Всегда приводит ссылки на источники и помечает надёжные (Government, Academic, Trusted) | Показывает ссылки, когда выполняет поиск; ответы без поиска идут без источников | Даёт ссылки при поиске; заметную долю источников составляют ресурсы Google, например YouTube |
| Работа с файлами | Документы, таблицы, аудио и видео до 40 МБ с недельным лимитом; в Проектах — до 100 МБ на файл | Сильная работа с разными типами файлов и анализ данных с выполнением кода | Работа с документами, большим контекстом и файлами из Google Диска |
| Удобство дополняющих вопросов | Сохраняет контекст треда, предлагает связанные вопросы, учитывает память (Memory) | Легко продолжает обсуждение, есть память между чатами | Поддерживает контекст диалога, связан с сервисами Google |
Сравнение с другими RAG-системами
Perplexity — это готовый продукт, ориентированный на конечного пользователя. Однако технология RAG используется и в других инструментах, предназначенных для разработчиков.
- LangChain RAG: Это не продукт, а фреймворк с открытым кодом (Python и JavaScript). Даёт максимальную гибкость для создания собственных RAG-приложений и агентов, работает практически с любыми LLM, включая отечественные GigaChat и YandexGPT. Требует навыков программирования для настройки и поддержки.
- OpenAI File Search: Инструмент поиска по загруженным файлам в Responses API. Старый Assistants API, на котором раньше строили такой RAG, отключён 26 августа 2026 года; теперь файлы и векторные хранилища (vector stores) используются через Responses API вместе с веб-поиском, выполнением кода и подключением MCP-серверов.
- Anthropic (Claude): В API есть загрузка документов (Files API), встроенное цитирование источников (Citations) и веб-поиск. В Claude Projects при большом объёме загруженных материалов автоматически включается режим RAG, а для повышения точности Anthropic предложила технику Contextual Retrieval.
Ключевое отличие Perplexity: это готовый к использованию продукт для конечного пользователя, а не набор инструментов для разработчика. Главная сила — поиск, анализ и цитирование в простом интерфейсе, поддержка русского языка и интеграции с рабочими платформами: Slack и Microsoft Teams (через Проекты), Microsoft 365 и более 400 приложений через коннекторы. Для разработчиков при этом есть своя API-платформа (см. раздел API).
Практические кейсы в образовании
Perplexity — это не "шпаргалка", а мощный инструмент для обучения студентов навыкам фактчекинга, поиска источников и критического анализа информации.
Примеры по направлениям
Подготовка обзора литературы
Задача: Быстро составить основу для раздела обзора литературы, выявить ключевые работы и определить текущее состояние исследований по теме.
Промпт: "Сделай обзор ключевых исследований за последние 5 лет на тему 'использование графена в солнечных панелях'. Сфокусируйся на академических источниках. Для каждой найденной статьи выдели: 1. Основную гипотезу. 2. Ключевые выводы. 3. Укажи, какие вопросы, по мнению авторов, остаются открытыми для будущих исследований."
Результат: Исследователь получает структурированную выжимку самой актуальной информации, экономя десятки часов на ручном поиске и чтении статей.

Анализ через разные теоретические призмы
Задача: Студент-философ анализирует классический текст.
Промпт: "Проанализируй концепцию 'сверхчеловека' Ницше с точки зрения экзистенциализма (Сартр, Камю) и психоанализа (Фрейд, Юнг). Выдели ключевые различия в интерпретациях, ссылаясь на работы ведущих исследователей в каждой из этих областей."
Результат: Студент получает глубокий сравнительный анализ, который выходит за рамки простого пересказа и учит применять теоретические фреймворки к сложным идеям.

Объяснение сложных концепций
Задача: Студент-физик пытается понять "Принцип неопределенности Гейзенберга".
Промпт: "Объясни принцип неопределенности Гейзенберга простыми словами. Используй аналогии. Затем приведи его строгое математическое выражение в формате LaTeX и ссылку на оригинальную работу Гейзенберга. Опирайся на научные источники (Academic)."
Результат: Perplexity предоставляет многоуровневый ответ: интуитивно понятная аналогия, точная формула и ссылка на первоисточник для углубленного изучения.

Фактчекинг и подготовка материала
Задача: Журналист готовит статью о влиянии социальных сетей на ментальное здоровье подростков.
Промпт: "Собери статистику и результаты исследований о влиянии различных типов активности в социальных сетях (например, общение, публикация контента, просмотр позитивного/негативного контента) на уровень депрессии и тревожности у подростков. Найди минимум 3 исследования из уважаемых рецензируемых журналов и 2 статьи из авторитетных СМИ (например, The Guardian, BBC)"
Результат: Журналист быстро получает массив проверенных данных с прямыми ссылками, экономя часы на поиске и верификации информации.

API и автоматизация
Для разработчиков у Perplexity есть API-платформа: Agent API (модели OpenAI, Anthropic, Google, xAI и других компаний со встроенным веб-поиском), Search API (ранжированная поисковая выдача без генерации текста) и Embeddings API. Agent API повторяет формат OpenAI Responses API, поэтому его легко встроить в существующие проекты.
Пример: API-запрос на Python
Скрипт отправляет вопрос в Agent API через официальный SDK perplexityai и выводит ответ по мере генерации. Параметр effort задаёт глубину работы (fast, low, medium, high, xhigh) — Perplexity сам подбирает модель и поисковые инструменты. Старые модели вроде pplx-7b-online давно отключены, а поддержка Sonar Chat Completions завершилась 27 сентября 2026 года: такие запросы теперь переводятся на Agent API.
# Установка: pip install perplexityai
import os
from perplexity import Perplexity

# Рекомендуется хранить ключ в переменной окружения PERPLEXITY_API_KEY
# (если она задана, достаточно написать client = Perplexity())
client = Perplexity(api_key=os.environ.get("PERPLEXITY_API_KEY"))

# Запрос к Agent API с потоковым выводом ответа
response_stream = client.responses.create(
    effort="low",
    input="Сколько звёзд в галактике Андромеды? Укажи источники.",
    stream=True,
)

for event in response_stream:
    if event.type == "response.output_text.delta":
        print(event.delta, end="")
Совместимость с OpenAI SDK: можно использовать привычную библиотеку openai — укажите base_url="https://api.perplexity.ai/v1" и вызывайте client.responses.create(). Чтобы выбрать конкретную модель, передайте её в формате провайдер/модель и добавьте инструмент веб-поиска tools=[{"type": "web_search"}].
Идеи для автоматизации в учебе и науке:
- Мониторинг новых публикаций: Скрипт, который ежедневно проверяет новые статьи по вашей теме на ArXiv и присылает вам краткие саммари.
- Автоматический фактчекинг: Инструмент, который принимает на вход текст и проверяет ключевые утверждения, возвращая список источников.
- Тематический агрегатор новостей: Сервис, который собирает самые важные новости по узкой теме (например, "квантовые сенсоры") из разных источников и формирует ежедневный дайджест.
- Чат-бот для консультаций: Создание собственного чат-бота, который отвечает на вопросы студентов по материалам курса, подкрепляя ответы ссылками на лекции и учебники.
- Поиск для ИИ-агентов: Подключение поиска Perplexity к агентам и редакторам кода через удалённый MCP-сервер (
https://api.perplexity.ai/mcp), чтобы агент сам находил актуальные данные со ссылками.
Проверь свои знания
Закрепите материал, пройдя небольшой интерактивный тест.
Часто задаваемые вопросы
Google — это поисковый движок, который дает вам список ссылок (индекс). Perplexity — это AI-поисковик, который анализирует эти ссылки за вас и предоставляет готовый, синтезированный ответ с цитатами. Google говорит: "Вот где можно найти информацию". Perplexity говорит: "Вот информация, которую вы искали, и вот откуда я ее взял". Google тоже добавляет ИИ-ответы (AI Overviews и AI Mode), но его основой по-прежнему остаётся поисковая выдача.
Нет, как и любому AI-инструменту. Сила Perplexity в том, что он предоставляет ссылки на источники и помечает надёжные из них. Ответ модели следует рассматривать как качественную отправную точку и гипотезу. Ваша задача — перейти по ссылкам и проверить контекст в первоисточниках. Это учит критическому мышлению, а не слепому доверию.
Это разные инструменты для разных задач, хотя границы между ними стираются: в ChatGPT появились веб-поиск и Deep Research, а в Perplexity — создание файлов и выбор моделей GPT, Claude и Gemini. ChatGPT остаётся универсальным ассистентом для творческих задач: написание кода, создание текстов, брейншторминг. Perplexity лучше подходит для исследовательских задач, где важны актуальность, точность и проверяемость информации: поиск и ссылки на источники в нём есть в каждом ответе. Если вам нужен факт — используйте Perplexity. Если вам нужна идея — используйте ChatGPT.
Если вы студент, ученый или аналитик и используете Perplexity ежедневно, то Pro-версия определенно стоит своих денег. Pro стоит $20 в месяц; для подтверждённых студентов и преподавателей есть Education Pro за $10 в месяц (с режимом обучения Learn Mode), а для самых активных пользователей — Max за $200 в месяц. Главные преимущества Pro — гораздо больше Pro-поисков и запросов Research (в бесплатной версии — 3 Pro-поиска в день и 1 Research в месяц), больше загрузок файлов, ручной выбор моделей (GPT-6.1 Sol, Claude Sonnet 5.5, Gemini 3.8 Flash, Kimi K3 и др.), создание файлов и приложений, Проекты и агент Computer. Для разовых запросов вполне хватит бесплатной версии.
Ключевые выводы
Мы рассмотрели Perplexity с разных сторон. Вот главные тезисы и важные предостережения:
1. Точность превыше всего
Главная сила Perplexity — в предоставлении точных, проверяемых ответов. Это ваш основной инструмент для исследований, а не для написания стихов.
2. Используйте Research, источники и Проекты
Для сложных запросов включайте режим Research (глубокое исследование). Выбирайте источники — Web, Academic, Social, Finance, — чтобы сузить область поиска и повысить релевантность результатов. Для долгих тем заводите Проект, чтобы файлы, инструкции и история работы были в одном месте.
3. Изучайте источники
Не останавливайтесь на сгенерированном ответе. Переходите по ссылкам, изучайте первоисточники. Perplexity — это дверь в мир информации, а не сама информация.
4. Критически оценивайте синтез
Даже при наличии верных источников модель может неправильно их интерпретировать или объединить. Всегда читайте контекст. Ответ ИИ — это гипотеза, которую нужно проверить.
Переходим к практике
Теперь вы можете не просто копировать шаблоны, а интерактивно создавать промпты, заполняя необходимые поля.
Начните ваше исследование
Перейдите на официальный сайт, чтобы начать использовать Perplexity для ваших задач прямо сейчас.
Перейти на Perplexity.aiЛитература и источники
Ключевые источники для дальнейшего изучения Perplexity и технологий RAG.
Список использованной литературы
Основополагающие работы по RAG
- Lewis, P. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks / P. Lewis, E. Perez, A. Piktus, [et al.] // arXiv preprint arXiv:2005.11401. – 2020. – URL: https://arxiv.org/abs/2005.11401 (дата обращения: 04.08.2025).
- Gao, L. Retrieval-Augmented Generation for Large Language Models: A Survey / L. Gao, X. Ma, J. Lin, [et al.] // arXiv preprint arXiv:2312.10997. – 2023. – URL: https://arxiv.org/abs/2312.10997 (дата обращения: 04.08.2025).
- Singh, A. Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG / A. Singh, A. Ehtesham, S. Kumar, [et al.] // arXiv preprint arXiv:2501.09136. – 2025. – URL: https://arxiv.org/abs/2501.09136 (дата обращения: 04.08.2025).
- Li, S. Enhancing Retrieval-Augmented Generation: A Study of Best Practices / S. Li, L. Stenzel, C. Eickhoff, S. A. Bahrainian // ACL Anthology COLING 2025. – 2025. – URL: https://aclanthology.org/2025.coling-main.449.pdf (дата обращения: 04.08.2025).
Исследовательские работы Aravind Srinivas
- Srinivas, A. Bottleneck transformers for visual recognition / A. Srinivas, T. Y. Lin, N. Parmar, [et al.] // Proceedings of the IEEE/CVF conference on computer vision and pattern recognition. – 2021. – P. 16519–16529.
- Srinivas, A. CURL: Contrastive unsupervised representations for reinforcement learning / A. Srinivas, M. Laskin, P. Abbeel // International Conference on Machine Learning. – 2020. – P. 9109–9119.
- Chen, L. Decision transformer: Reinforcement learning via sequence modeling / L. Chen, K. Lu, A. Rajeswaran, [et al.] // Advances in Neural Information Processing Systems. – 2021. – Vol. 34. – P. 15084–15097.
Технические исследования Perplexity AI
- Perplexity Sonar Dominates New Search Arena Evaluation / Perplexity AI Team // Perplexity Blog. – 2025. – URL: https://www.perplexity.ai/hub/blog/perplexity-sonar-dominates-new-search-arena-evolution (дата обращения: 04.08.2025).
- Introducing Perplexity Deep Research / Perplexity AI Team // Perplexity Blog. – 2025. – URL: https://www.perplexity.ai/hub/blog/introducing-perplexity-deep-research (дата обращения: 04.08.2025).
Официальная документация и API ресурсы
- Perplexity API Documentation / Perplexity AI. – 2026. – URL: https://docs.perplexity.ai/ (дата обращения: 09.11.2026).
- Agent API Quickstart / Perplexity AI // Perplexity API Documentation. – 2026. – URL: https://docs.perplexity.ai/docs/agent-api/quickstart (дата обращения: 09.11.2026).
- Which Perplexity Subscription Plan is right for you? / Perplexity AI // Perplexity Help Center. – 2026. – URL: https://www.perplexity.ai/help-center/en/articles/11187416-which-perplexity-subscription-plan-is-right-for-you (дата обращения: 09.11.2026).
- What are Projects? / Perplexity AI // Perplexity Help Center. – 2026. – URL: https://www.perplexity.ai/help-center/en/articles/10352961-what-are-projects (дата обращения: 09.11.2026).
- What is Research mode? / Perplexity AI // Perplexity Help Center. – 2026. – URL: https://www.perplexity.ai/help-center/en/articles/10738684-what-is-research-mode (дата обращения: 09.11.2026).
- What is Computer? / Perplexity AI // Perplexity Help Center. – 2026. – URL: https://www.perplexity.ai/help-center/en/articles/13837784-what-is-computer (дата обращения: 09.11.2026).